Automatización 14 de noviembre de 2026 · 15 min
Guía para automatizar tareas SEO con IA: Flujos, agentes y n8n
El sector busca reducir drásticamente las horas invertidas en tareas operativas implementando sistemas reales y escalables, dejando atrás el simple copiado y pegado. En esta guía explico cómo automatizar tareas SEO con IA mediante flujos de trabajo en n8n, integrando datos de herramientas profesionales y manteniendo siempre el control humano para garantizar la calidad.
¿Por qué automatizar tareas SEO con IA va más allá de copiar y pegar prompts?
La integración de la inteligencia artificial en el trabajo diario de un consultor o departamento de marketing ha pasado por varias fases. La primera fue la interacción manual: abrir una interfaz de chat, pegar un listado de palabras clave y pedir una clasificación. Aunque esto ahorra tiempo frente a la ejecución puramente manual, no es verdadera automatización. Es simplemente delegar una tarea aislada a un asistente conversacional que, por defecto, carece de estado y contexto a largo plazo.
Para escalar las operaciones, las empresas necesitan construir verdaderos flujos de trabajo n8n SEO (o en plataformas similares) donde la extracción de datos, el procesamiento, la toma de decisiones lógicas y la generación de salidas ocurran de forma secuencial y programada. Aquí es donde entra el concepto de los agentes IA SEO: sistemas diseñados para ejecutar procesos de varios pasos con un objetivo específico, conectándose a fuentes de datos externas y aplicando reglas de negocio predefinidas.
El objetivo no es que la IA haga el trabajo del consultor de principio a fin de forma autónoma, sino implementar un modelo human in the loop (humano en el bucle). En este modelo, la máquina se encarga de la recolección masiva de datos (por ejemplo, extraer métricas de rendimiento y perfiles de enlaces), el procesamiento pesado (agrupar miles de URLs por intención de búsqueda) y la propuesta de acciones. El consultor humano interviene al final del flujo para revisar, ajustar y aprobar. Yo lo haría así siempre, ya que es la única forma de garantizar que no se genere contenido de baja calidad o se tomen decisiones técnicas erróneas basadas en alucinaciones del modelo.
El espejismo de las ventanas de contexto kilométricas
Uno de los mayores retos al construir automatizaciones complejas es la gestión de la información. Según la documentación técnica sobre la memoria de los agentes, los Modelos de Lenguaje Grande (LLMs) no tienen estado por defecto. Cada llamada comienza en frío, sin ningún recuerdo de los turnos anteriores o del contexto acumulado. Para los agentes de IA que abarcan flujos de trabajo de múltiples pasos donde cada nuevo paso depende del anterior, esta restricción se convierte en un obstáculo monumental en producción.
Expandir las ventanas de contexto de unos pocos miles de tokens a un millón ha creado la falsa impresión de que la memoria de los agentes de IA es un problema resuelto. En la práctica, no lo es en absoluto. Los agentes en producción que dependen únicamente del contexto siguen cayendo en los mismos modos de fallo que los modelos anteriores de ventana más pequeña, solo que ahora lo hacen con costes de tokens mucho más altos y en demostraciones que parecen más elaboradas.
Existen tres problemas fundamentales al usar solo la ventana de contexto como memoria para tus automatizaciones SEO:
1. Degradación del contexto antes de alcanzar la capacidad
Aunque los LLMs de contexto largo soportan la recuperación a través de cientos de miles de tokens, la precisión de la recuperación se degrada mucho antes de alcanzar el límite establecido. La información colocada en el medio de un contexto largo tiende a perderse, causando a menudo alucinaciones de la IA. En la práctica, esto significa que un dato relevante (por ejemplo, una directriz técnica sobre canonicals) situado en la posición 50.000 dentro de una ventana de 200.000 tokens se recupera con mucha menos fiabilidad que el mismo dato si estuviera en los primeros o últimos miles de tokens. Tratar la longitud del contexto como un sustituto de la memoria significa asumir una calidad de recuperación que, de hecho, no existe.
2. Falta de prominencia o priorización (Salience)
Las ventanas de contexto no saben qué es lo que realmente importa. Cada token recibe un peso basado en el mecanismo de atención del modelo, independientemente de si se trata de una preferencia del usuario, un comentario aislado o una instrucción crítica de negocio. Sin una memoria externa que clasifique explícitamente la relevancia o utilice reglas de extracción específicas, los hechos importantes compiten con el relleno conversacional por la atención del LLM, y a menudo pierden. Además, el escalado del coste de los tokens hace que la alternativa de fuerza bruta sea económicamente dolorosa: pasar el historial completo de interacción en cada llamada quema el presupuesto rápidamente.
3. Ausencia de memoria entre sesiones
Las sesiones sin estado significan que un agente que ayudó a un usuario ayer no tiene registro de esa interacción hoy, incluso cuando ambas ejecuciones ocurrieron en la misma cuenta. Sin una memoria persistente que sobreviva a través de las sesiones, cada conversación o ejecución de flujo comienza desde cero. Cualquier estrategia de gestión de memoria del agente que viva completamente en el contexto se evapora en el momento en que se cierra la sesión, terminando en una pérdida silenciosa de datos.
La arquitectura de los agentes IA SEO: El framework CoALA
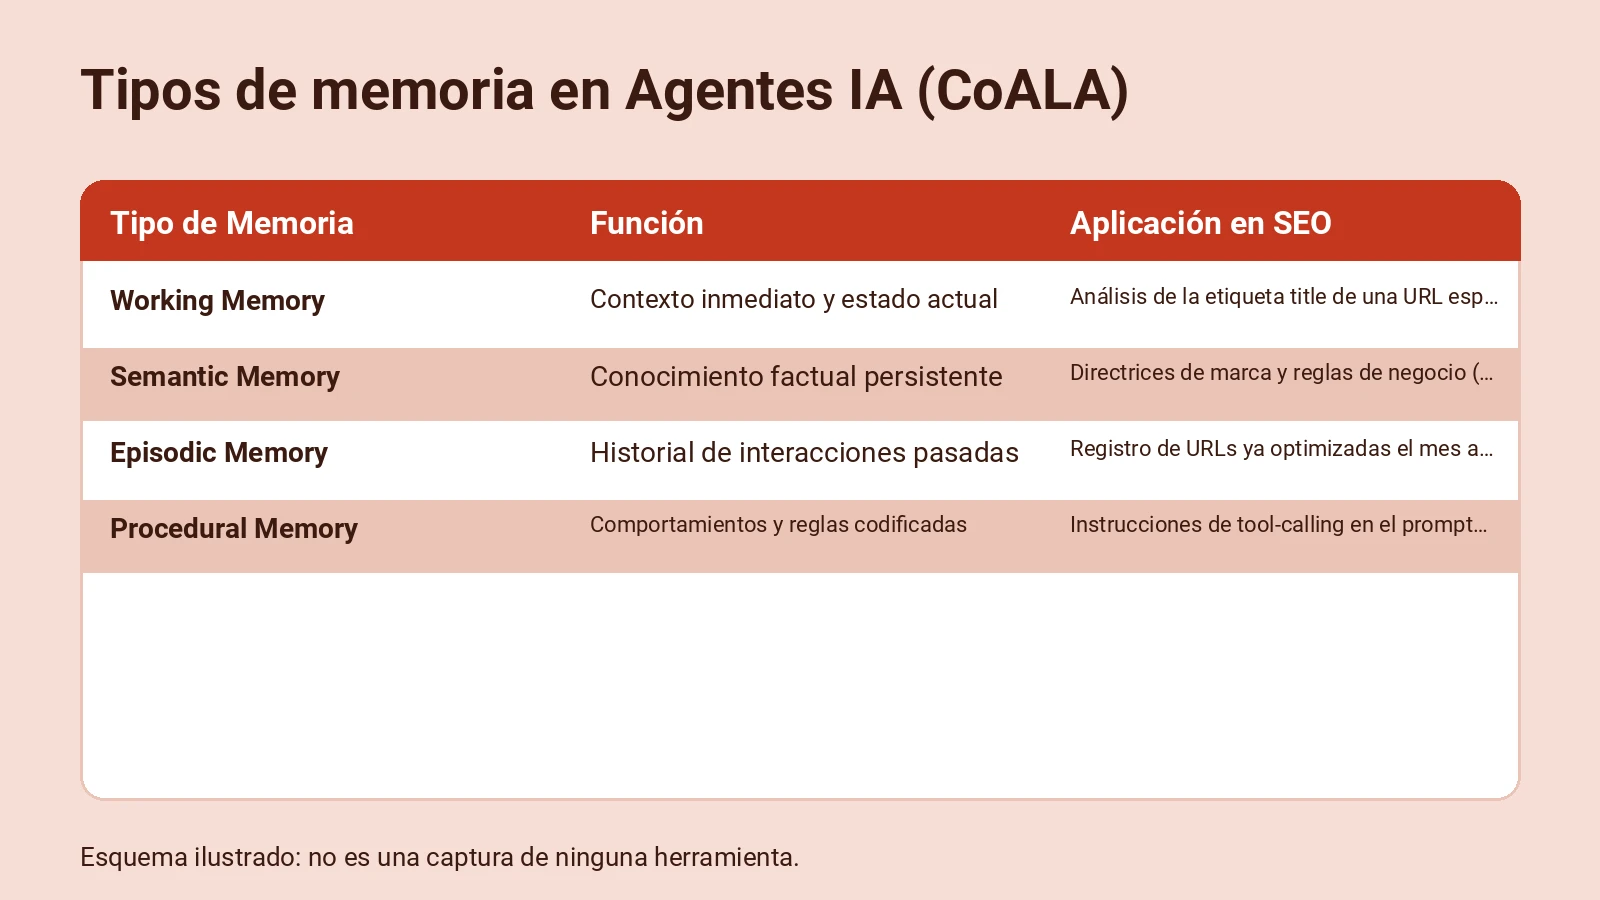
Para resolver el problema del estado y la memoria, los profesionales piensan en los tipos de memoria de los agentes utilizando el marco CoALA (Cognitive Architectures for Language Agents), extraído de la ciencia cognitiva y ampliamente referenciado en el espacio de la IA de agentes. Este marco separa la memoria por lo que representa, no por dónde se almacena físicamente. Esto significa que primero eliges el tipo de memoria basándote en tu lógica de negocio SEO, y luego decides cómo implementarla.
Memoria de trabajo (In-context / Working memory)
Esta memoria retiene lo que el agente está procesando en este momento exacto: el prompt actual, los turnos recientes y el estado inmediato de la tarea. Se asimila a cómo retienes los puntos clave de una conversación mientras decides qué decir a continuación. Sus contenidos desaparecen cuando termina la sesión. En términos de LLM, la memoria de trabajo vive dentro de la ventana de contexto junto con las instrucciones del sistema, las descripciones de las herramientas y el mensaje actual. En SEO, esto sería el análisis en tiempo real de una etiqueta title o la evaluación de una métrica específica de Core Web Vitals para una URL concreta.
Memoria semántica (Conocimiento factual)
Este tipo de memoria de IA almacena el conocimiento general que el agente debe saber independientemente de cuándo o dónde se recopiló. En un entorno corporativo, esto incluye políticas de la empresa, documentación del producto, contenido de preguntas frecuentes y conocimiento del dominio. A diferencia de la memoria de trabajo, las memorias semánticas persisten a través de las sesiones y no están vinculadas a una interacción específica.
Típicamente, se codifican como embeddings en bases de datos vectoriales, que soportan la recuperación basada en similitud a escala. Esta es la misma primitiva de recuperación que utiliza RAG (Retrieval-Augmented Generation) para buscar fragmentos de documentos. La memoria semántica a menudo almacena el mayor volumen de conocimiento del agente en producción. El volumen de hechos que un agente acumula a lo largo de meses de operación supera cualquier ventana de contexto mucho antes de superar un almacén vectorial adecuadamente indexado.
Memoria episódica (Historial de interacciones)
Registra lo que sucedió durante interacciones pasadas específicas, incluyendo cuándo ocurrió cada intercambio, qué se dijo y qué hizo el agente. Permite al agente basar sus respuestas en un historial compartido. Las memorias episódicas se acumulan con el tiempo y requieren una indexación temporal, que importa tanto como el contexto semántico de lo que sucedió.
Sin esa capa temporal, la recuperación devuelve hechos que el agente supo una vez pero que no puede ubicar en el tiempo, produciendo posiblemente respuestas en las que se muestra confiadamente equivocado. Para un agente SEO, la memoria episódica es vital: si el agente optimiza meta descripciones semanalmente, esta memoria le permite saber qué descripciones ya se cambiaron el mes pasado para no volver a procesarlas de forma redundante. Crece continuamente y puede convertirse en el nivel de mayor volumen en un agente maduro.
Memoria procedimental (Comportamientos codificados)
Este tipo de memoria captura cómo el agente hace las cosas, como secuencias de llamadas a herramientas (tool-calling), patrones de respuesta y reglas de escalado. Es el análogo más cercano a la memoria muscular humana: comportamientos codificados que no necesitan ser redefinidos en cada sesión. La mayoría de los frameworks integran la memoria procedimental en el prompt del sistema. Las configuraciones más sofisticadas extraen patrones de los datos episódicos acumulados y actualizan la memoria procedimental con el tiempo, de modo que el agente mejora en las tareas rutinarias cuanto más las ejecuta.
Estrategias de almacenamiento y recuperación en n8n
Las decisiones de almacenamiento determinan qué memorias son accesibles en tiempo de ejecución. Las decisiones de recuperación determinan qué subconjunto sale a la superficie hacia el LLM en cualquier llamada dada. Ambas importan, y acertar en una no garantiza la otra.
El patrón más simple mantiene el historial de conversación reciente en un búfer de ventana deslizante (sliding window buffer) que se pasa al LLM en cada llamada. Cuando el búfer se llena, las entradas más antiguas pueden resumirse o descartarse selectivamente. La primera opción preserva los puntos clave sin consumir los presupuestos completos de tokens. La segunda elimina las entradas menos relevantes mientras mantiene las que importan, previniendo la pérdida total de contexto.
La sumarización comprime el historial de interacción a costa de los detalles y necesita una llamada extra al LLM para generar el resumen. Funciona bien para agentes de chat, pero se rompe para agentes de programación o flujos de trabajo donde las salidas previas necesitan ser exactas.
Conectando el ecosistema: APIs, MCP y Analítica de Bots
Para que un agente sea útil, necesita datos reales. Automatizar SEO con n8n permite orquestar peticiones a las APIs de las herramientas que ya utilizas. Una automatización marketing n8n bien planteada funciona como el sistema nervioso central de tus operaciones.
Por ejemplo, puedes integrar los datos de Ahrefs de múltiples formas. Según la documentación para desarrolladores de Ahrefs, su API REST permite investigar palabras clave, analizar backlinks, rastrear clasificaciones y monitorizar la visibilidad de la marca en plataformas de búsqueda tradicionales y de IA. Puedes extraer métricas clave como el Domain Rating (DR) o los Dominios de Referencia para enriquecer el análisis de tu agente.
Más allá de la API REST tradicional, Ahrefs ha implementado MCP (Model Context Protocol). Esto permite conectar los datos de Ahrefs directamente a asistentes y agentes de IA para mejorar sus respuestas con información real de marketing. Se puede configurar para Claude Desktop, web, ChatGPT, e incluso integrarlo en flujos de trabajo de programación con Claude Code.
Otro aspecto fundamental para el SEO técnico es el análisis de logs. Ahrefs ofrece Bot Analytics para entender cómo los bots interactúan con tu sitio web, rastrear la actividad de crawl, identificar tipos de bots y monitorizar su impacto. Esto se puede configurar mediante Cloudflare Logpush (recomendado para configuraciones de Cloudflare Enterprise) o mediante Cloudflare Worker para cualquier plan de Cloudflare. Un agente en n8n podría ingerir estos logs para detectar ineficiencias en el presupuesto de rastreo.
Además, es posible construir paneles personalizados con los conectores de Ahrefs para Google Data Studio (Site Explorer, Rank Tracker, Site Audit y Brand Radar), y utilizar Ahrefs Connect (basado en OAuth 2.0) para llevar datos a aplicaciones de terceros. Todo este ecosistema de datos debe cruzarse con fuentes oficiales, manteniéndose al día con las directrices del Blog del SEO y de la Búsqueda de Google (cuya última actualización documentada es del 31 de octubre de 2024).
Seguridad y resiliencia: Implementando Gemini 4 Carbon en n8n
Cuando automatizas la extracción de datos de sitios web externos (por ejemplo, para analizar a la competencia, leer correos entrantes, procesar payloads de webhooks o revisar páginas scrapeadas), introduces información no confiable en tu sistema. Cualquiera de estas entradas puede llevar instrucciones ocultas diseñadas para secuestrar a tu agente, un ataque conocido como inyección de prompts (prompt injection).
Para mitigar esto, la elección del modelo de lenguaje es crítica. Google ha lanzado Gemini 4 Carbon, ya disponible en n8n, presentándolo como su modelo más fuerte hasta la fecha, con grandes ganancias en programación, trabajo de agentes de larga duración y ciberseguridad.
Lo que Carbon aporta a tus agentes n8n se divide en tres áreas clave:
- Fuerte en seguridad: Carbon lidera los benchmarks a través del ciclo de vida de defensa: encontrando vulnerabilidades (88.2% en SEC-bench Pro), comprobando cuáles son explotables (54.8% en ExploitGym) y parcheándolas (71.0% en CWE-bench). Si tu equipo ejecuta flujos de trabajo de seguridad o auditorías técnicas profundas, este modelo es ideal.
- Construido para el largo plazo: Carbon maneja tareas largas y de múltiples pasos. Google informa que las ejecuciones de equipos internos han durado días en problemas de ingeniería complejos, superando callejones sin salida en lugar de detenerse como se veía anteriormente. En n8n, eso significa que tus agentes pueden trabajar a través de más pasos y llamadas a herramientas antes de perder el hilo. En el benchmark AutomationBench, Carbon obtuvo un 53.9%.
- Agentes más fiables: En el benchmark de inyección de prompts de Gray Swan, Carbon resistió todos los ataques (0.0% de tasa de éxito, bajando desde el 0.7% de su predecesor, Argon). Aunque esta es una mejora real, ningún modelo es completamente resistente a ataques maliciosos a escala, por lo que debes mantener tus protocolos de seguridad.
Si ya estás usando Gemini 4 Argon, no necesitas cambiar todo. La mejor estrategia es usar Carbon para los pasos del agente que necesitan un razonamiento pesado, y mantener Argon (o un modelo más ligero) para trabajos simples como clasificar o formatear.
Casos de uso hipotéticos en automatización SEO
Para ilustrar cómo se materializa toda esta teoría, veamos dos ejemplos hipotéticos de cómo se podrían estructurar flujos en n8n. Estos procesos no sustituyen al consultor, sino que preparan el terreno para que este tome decisiones informadas.
Ejemplo hipotético 1: Sistema de pre-auditoría técnica y de contenidos
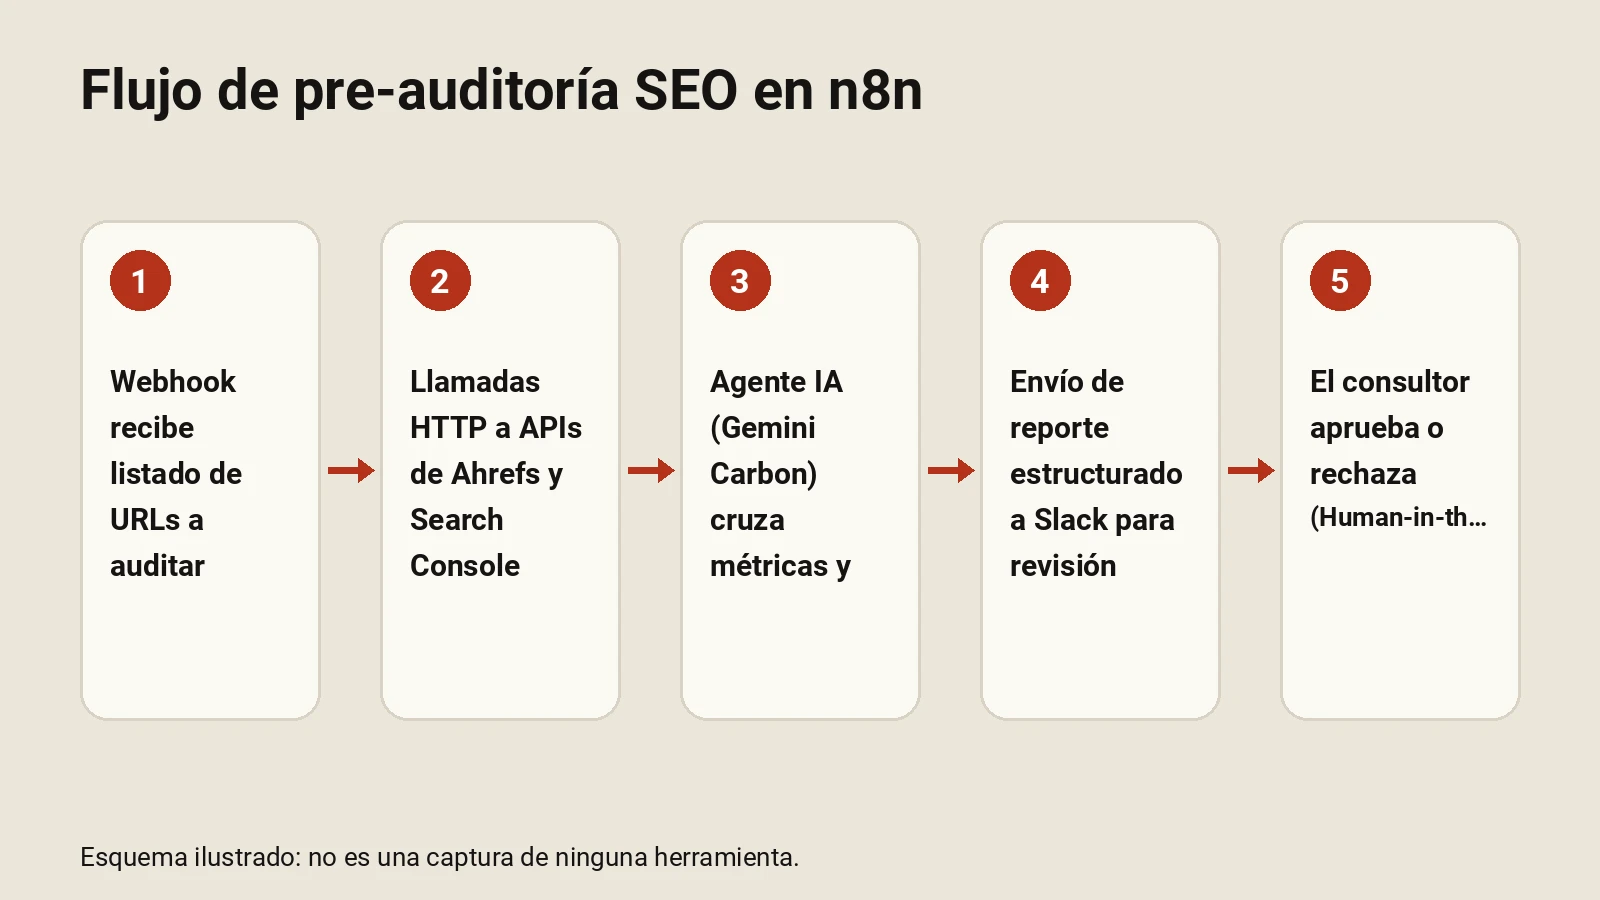
- Disparador (Trigger): El flujo se inicia mediante un Webhook en n8n que recibe un listado de URLs desde un formulario interno.
- Extracción de datos (Nodos HTTP): El sistema realiza llamadas paralelas. Por un lado, consulta la API REST de Ahrefs para obtener el Domain Rating (DR) y los dominios de referencia. Por otro, extrae datos de rendimiento.
- Procesamiento con IA (Nodo AI Agent): Todos estos datos estructurados se pasan a un agente configurado con Gemini 4 Carbon. El agente utiliza su memoria procedimental (instrucciones del sistema) para cruzar los datos de tráfico con el perfil de enlaces, buscando anomalías.
- Aprobación Humana (Human in the loop): El agente no publica cambios en el CMS. En su lugar, envía un resumen estructurado a Slack. El mensaje incluye botones interactivos. Solo si el consultor aprueba, el flujo continúa.
Ejemplo hipotético 2: Análisis de alertas de seguridad y logs de bots
Imagina que gestionas el SEO técnico de un gran e-commerce y necesitas controlar el presupuesto de rastreo y la seguridad web.
- Disparador: Una alerta de seguridad o un pico anómalo de rastreo aterriza vía webhook desde Cloudflare Logpush.
- Investigación del Agente: Tu agente en n8n, ejecutando Gemini 4 Carbon, lee la alerta. Utiliza herramientas integradas para extraer los logs relacionados de Bot Analytics.
- Evaluación y Priorización: El agente comprueba los datos contra problemas conocidos (usando su memoria semántica almacenada en una base de datos vectorial), establece una prioridad para la alerta. El texto de la alerta es una entrada no confiable, que es exactamente donde la resistencia a la inyección de prompts de Carbon vale la pena.
- Notificación: El agente publica un resumen detallado en Slack para el ingeniero de guardia o el consultor SEO técnico, permitiendo una acción rápida y documentada.
Errores frecuentes al automatizar tareas SEO con IA
La implementación de estas arquitecturas conlleva curvas de aprendizaje técnico. Estos son los fallos operativos más comunes en el despliegue de automatizaciones SEO:
1. Automatización total sin supervisión humana
Creer que la IA puede operar de manera completamente autónoma en SEO es un error grave. Si conectas un agente directamente a tu CMS para que publique clústeres de contenido o modifique meta etiquetas sin revisión, acabarás generando contenido de baja calidad o desalineado con la intención de búsqueda real. El humano debe ser el validador final de la estrategia.
2. Depender exclusivamente de la ventana de contexto
Como vimos anteriormente, tratar la longitud del contexto como un sustituto de la memoria termina en pérdida silenciosa de datos y alucinaciones por la degradación del contexto. Es imperativo utilizar el framework CoALA, fragmentar los datos, usar bases de datos vectoriales para la memoria semántica y procesar por lotes.
3. Ignorar la seguridad de los inputs
Los agentes SEO leen constantemente entradas que no controlas. Si no utilizas modelos robustos contra la inyección de prompts (como se ha demostrado con el 0.0% de éxito de ataques en Carbon) o no sanitizas los datos antes de pasarlos al LLM, tu automatización es vulnerable a manipulaciones externas que podrían comprometer tu sitio web o tus datos.
Costes operativos de la automatización
La viabilidad de automatizar tareas SEO con IA depende del retorno de inversión y de los costes de las APIs involucradas. En el caso de los LLMs, el modelo de precios por tokens define la arquitectura.
Google ha lanzado Gemini 4 Carbon al mismo precio introductorio que Argon. Los costes son los siguientes:
- Precio introductorio (hasta el 30 de noviembre de 2026): $2 por millón de tokens de entrada (input) y $10 por millón de tokens de salida (output).
- Precio regular (después del periodo introductorio): $4 por millón de tokens de entrada y $20 por millón de tokens de salida.
Para usarlo en n8n, tienes dos opciones. En n8n Cloud, puedes usar Carbon a través de créditos Gateway, por lo que no hay una cuenta de proveedor separada ni facturación extra. En la versión autoalojada (self-hosted), simplemente añades tu propia clave API de Gemini.
A estos costes hay que sumar las cuotas de las herramientas SEO tradicionales (como los créditos de la API de Ahrefs) y la infraestructura de alojamiento. Sin embargo, el coste computacional es marginal comparado con las horas de consultoría ahorradas en la extracción y cruce manual de datos en hojas de cálculo. Pasar historiales completos quema presupuesto, por lo que implementar búferes de sumarización es clave para mantener la rentabilidad.
Conclusión sobre el futuro operativo del SEO
En mi opinión, el SEO técnico y operativo se está convirtiendo en un desafío de ingeniería de datos. La ventaja competitiva ya no reside en saber qué datos mirar, sino en la capacidad de estructurar sistemas que extraigan, procesen y presenten esos datos de forma eficiente a los tomadores de decisiones.
La implementación de flujos en n8n combinados con agentes de IA y modelos robustos como Gemini 4 Carbon no es una forma de reemplazar al profesional SEO, sino de liberarlo de la carga operativa repetitiva. Al delegar la recolección, el manejo de la memoria (semántica, episódica, procedimental y de trabajo) y el procesamiento inicial a la máquina, el consultor puede dedicar su tiempo a la estrategia, la experimentación y la validación. Si tu empresa necesita optimizar sus procesos internos y escalar sus operaciones de marketing, el diseño de arquitecturas de automatización con IA es el paso lógico para garantizar la eficiencia y la precisión en un entorno digital cada vez más complejo.
Preguntas frecuentes
¿Qué es un agente IA SEO?
Un agente IA SEO es un sistema automatizado que utiliza modelos de lenguaje (LLMs) para ejecutar flujos de trabajo de varios pasos. A diferencia de un simple chat, el agente puede conectarse a APIs externas, tomar decisiones lógicas basadas en reglas y procesar datos de forma secuencial.
¿Por qué es importante el modelo human-in-the-loop en la automatización SEO?
El modelo human-in-the-loop asegura que un consultor humano revise y apruebe las acciones propuestas por la IA antes de su implementación. Esto es vital para evitar la publicación de contenido de baja calidad, prevenir el spam y corregir posibles alucinaciones del modelo.
¿Qué ventajas tiene usar n8n para automatizar tareas SEO?
n8n permite orquestar flujos de trabajo complejos conectando de forma visual y programática APIs de herramientas SEO (como Ahrefs o Google Search Console) con modelos de inteligencia artificial. Facilita la creación de pipelines escalables sin depender exclusivamente de integraciones prefabricadas rígidas.
¿Cómo afecta la memoria de los LLMs a las automatizaciones largas?
Los LLMs no tienen estado por defecto, por lo que no recuerdan interacciones pasadas. Para automatizaciones largas, es necesario implementar sistemas de memoria externa (como bases de datos vectoriales para memoria semántica) para evitar la degradación del contexto y la pérdida de información.
Fuentes
- AI agent memory: Types, storage, and retrieval guide – n8n Blog
- Build Safer n8n Agents and Workflows with Google Gemini 4 Carbon – n8n Blog
- Blog del SEO y de la Búsqueda | Centro de la Búsqueda de Google | Google Search Central Blog | Google for Developers
- Ahrefs for Developers
¿Te ayudo con esto? Soy consultor SEO y GEO en Murcia y monto automatizaciones con IA para empresas. Cuéntame tu caso o mira mis servicios de SEO, GEO y automatización.